sábado, febrero 05, 2011

Festival Latinoamericano de Instalación de Software Libre (FLISoL)

headbox2011.png

¿Qué es el FLISoL?

El Festival Latinoamericano de Instalación de Software Libre (FLISoL) es el evento de difusión de Software Libre más grande en Latinoamérica. Se realiza desde el año 2005 y desde el 2008 se adoptó su realización el 4to Sábado de abril de cada año. En 2011 por única vez será el día 9 de Abril.

Su principal objetivo es promover el uso del software libre, dando a conocer al público en general su filosofía, alcances, avances y desarrollo.

A tal fin, las diversas comunidades locales de software libre (en cada país/ciudad/localidad), organizan simultáneamente eventos en los que se instala, de manera gratuita y totalmente legal, software libre en las computadoras que llevan los asistentes. Además, en forma paralela, se ofrecen charlas, ponencias y talleres, sobre temáticas locales, nacionales y latinoamericanas en torno al Software Libre, en toda su gama de expresiones: artística, académica, empresarial y social.

¿Cómo me entero si en mi ciudad se realizará el evento?

Puedes revisar en Ciudades, allí podrás encontrar todas las ciudades sedes donde se realiza el evento, o puedes seguir los enlaces por países que aparecen en el menú a tu izquierda. Podrás encontrar información sobre el lugar de realización del evento y los contactos respectivos de las personas, grupos y entidades a cargo.
Si por otra parte, en tu país y/o ciudad no hay programado evento todavía, eres un entusiasta y estás interesado en organizar y/o promover, por favor consulta esta información.

Usuarios de Software Libre y de Software Privativo

Durante mucho tiempo solo use software privativo. No sabía de la existencia del software libre hasta mis últimos años de universidad. Cuando empecé a usar la computadora utilizaba solo el software que venía en la misma. Luego descubrí que existía software que podía utilizar si algún amigo me lo compartía, con el tiempo descubrí que eso era ilegal.

Fue entonces cuando estaba cerca de tener mis 15 años convencí a mi mamá que me compre Windows 95. Con el tiempo salieron nuevas aplicaciones y simplemente me era muy caro comprar todas las que mis amigos tenían. Entonces aprendí que era más fácil y práctico copiar todas estas aplicaciones, al igual que lo hacían mis amigos. Podía ser que estaba infringiendo la ley, pero era eso o no usar la computadora.

Luego en la universidad era peor, porque el software que utilizaba costaba en el orden de los cientos de dólares. Yo no tenía otra posibilidad que infringir la ley, al igual que todos mis compañeros y hasta profesores. Recuerdo que tenía profesores que nos decían donde comprar el software ilegal y como hacer para crakearlo.

Luego cuando descubrí el software libre, aprendí que copiar software no era malo. Es más los desarrolladores de software libre invitan a hacerlo. Descubrí toda una comunidad de usuarios dispuesta apoyarme en lo que necesitaba. En más de una ocasión llegué a tener comunicación directa con los desarrolladores de Software Libre. Hoy ayudo a empresas a compartir su software en la web y establecer enlaces. Algunos serán usuarios, otros socios de negocios, otros colaboradores y otros clientes.

He aquí la diferencia entre el usuario de software privativo y el de software libre. El de software privativo se ve obligado a infringir la ley y ve a las personas que desarrollan el software como inalcanzables. Los usuarios de software libre somos parte de una comunidad donde somos orgullos de mostrar el software que utilizamos y no infringimos la ley.

Fuente: Rafael Bonifaz

viernes, febrero 04, 2011

Bioinformática

De igual forma diremos que la bioinformática, según una de sus definiciones más sencillas, es la aplicación de tecnología de computadores a la gestión y análisis de datos biológicos. Los términos bioinformática, biología computacional y, en ocasiones, biocomputación, utilizados en muchas situaciones como sinónimos, hacen referencia a campos de estudios interdisciplinarios muy vinculados, que requieren el uso o el desarrollo de diferentes técnicas que incluyen informática, matemática aplicada, estadística, ciencias de la computación, inteligencia artificial, química y bioquímica para solucionar problemas, analizar datos, o simular sistemas o mecanismos, todos ellos de índole biológica, y usualmente (pero no de forma exclusiva) en el nivel molecular. El núcleo principal de estas técnicas se encuentra en la utilización de recursos computacionales para solucionar o investigar problemas sobre escalas de tal magnitud que sobrepasan el discernimiento humano. La investigación en biología computacional se solapa a menudo con la biología de sistemas.
Los principales esfuerzos de investigación en estos campos incluyen el alineamiento de secuencias, la predicción de genes, montaje del genoma, alineamiento estructural de proteínas, predicción de estructura de proteínas, predicción de la expresión génica, interacciones proteína-proteína, y modelado de la evolución.
Una constante en proyectos de bioinformática y biología computacional es el uso de herramientas matemáticas para extraer información útil de datos producidos por técnicas biológicas de alta productividad, como la secuenciación del genoma. En particular, el montaje o ensamblado de secuencias genómicas de alta calidad desde fragmentos obtenidos tras la secuenciación del ADN a gran escala es un área de alto interés. Otros objetivos incluyen el estudio de la regulación genética para interpretar perfiles de expresión génica utilizando datos de chips de ADN o espectrometría de masas.

viernes, diciembre 10, 2010

Los orígenes de la Bioinformática (IV): the rise of the machines

(Para los que sois nuevos en este blog, ésta es la cuarta entrega de una serie de entradas basadas en el material aportado por David, que es un artículo en Nature Reviews Genetics del año 2000 de Joel B. Hagen, titulado “The origins of bioinformatics”.)

Tras las 3 entregas anteriores, donde hemos visto cómo se descubrían y establecían algunos de los paradigmas sobre los que se sostiene la biología molecular moderna, todavía os estaréis preguntando “Éste es un blog de Bioinformática. ¿Y cuando salen los ordenadores?”. Pues ha llegado el momento de escribir sobre cómo se empezó a introducir el uso de los ordenadores, y cómo empezó a nacer la biología computacional.

A finales de los años 50 el mundo académico (en Estados Unidos, se entiende) empezó a tener acceso no restringido a los ordenadores, que hasta ese momento sólo habían tenido un uso militar. De todos los descubrimientos de esa época en el área de las ciencias de la vida, sólo se puede decir que los ordenadores tuvieron un papel determinante en la resolución de la estructura tridimensional de la mioglobina en 1957 (mediante la técnica de cristalografía de rayos X). Estos ordenadores estaban basados en válvulas de vacío, y se programaban a bajo nivel (no se podían reutilizar los programas), pero ayudaron a comenzar el desarrollo de técnicas computacionales y de desarrollo de software en el mundo académico.

IBM 7090

Ya a principios de la década de 1960 había un acceso casi generalizado en el mundo académico a los ordenadores. Algunas universidades empezaron a comprar ordenadores de segunda generación, basados en transistores, que además empezaban a llevar lenguajes de alto nivel. El primer lenguaje en alto nivel disponible fue FORTRAN, que fue desarrollado inicialmente por IBM para sus máquinas, lo cuál permitió que se pudiera empezar a reutilizar los programas desarrollados en otros ordenadores con arquitecturas diferentes.

Y aquí entra en juego Margaret Oakley Dayhoff (sitio oficial http://www.dayhoff.cc/), una de las pioneras de la Bioinformática. Ella comenzó con una preparación en química cuantitativa y matemáticas, y alrededor de los años 60 empezó a estar interesada en el mundo de las proteínas y la evolución molecular. Tuvo un buen punto de partida para sus intereses científicos, al ser en aquella época directora asociada de la recién creada National Biomedical Research Foundation, una fundación interesada en la promoción y aplicación de las técnicas computacionales para ayudar en la investigación médica. Margaret Dayhoff empezó a explorar las distintas técnicas matemáticas para analizar los ya crecientes datos de secuencias de aminoácidos.

Margaret Dayhoff, 1951, antes de dedicarse a la BioinformáticaA lo largo de sus investigaciones recibió fondos de NIH (National Institutes of Health), NSF (National Science Foundation), NASA (National Aeronautics and Space Administration) y la corporación IBM. Estas investigaciones se movían en varios frentes, de los cuáles el primero fue la escritura de una serie de programas en FORTRAN para determinar la secuencias de aminoácidos de las moléculas de proteínas. Estos programas tomaban fragmentos de péptidos obtenidos de la digestión parcial de una proteína, y calculaban todas las posibles secuencias compatibles con los ensamblajes de esos péptidos. Estos programas servían para resolver el mismo puzzle que tuvieron que resolver a mano durante varios meses los equipos que secuenciaron la ribonucleasa o la insulina, con la diferencia de que sus programas fueron capaces de llegar a la solución correcta en unos pocos minutos para la ribonucleasa.

Margaret Dayhoff no fue la única en su época dedicada a la creación de estos primeros programas de ensamblaje. Todos los investigadores que trabajaban en aquella época en este campo se dieron inmediatamente cuenta de que la misma metodología se podrían aplicar al ensamblaje de secuencias genómicas cuando las técnicas experimentales estuvieran disponibles.

Los programas de análisis de secuencias en aquella época siguieron los principios introducidos por el analizador automático de aminoácidos de Stein y Moore. Tanto los programas como el aparato estaban enfocados en recopilar rápidamente una biblioteca de secuencias que pudiera ser usada en estudios de bioquímica comparativa y evolución molecular. Y para promocionar este objetivo, Dayhoff fundó el Atlas of Protein Sequence and Structure (atlas de secuencia y estructura de proteínas), una publicación anual que intentaba catalogar todas las secuencias de aminoácidos conocidas. De forma muy rudimentaria, ésta fue la primera base de datos de información sobre biología molecular, y se convirtió en el recurso indispensable para las primeras investigaciones computacionales.

Con el paso del tiempo (y la creación de internet y la web) esta publicación evolucionó hasta convertirse en 1983 en una de las principales bases de datos online, PIR (the Protein Information Resource). Se convirtió en un importante punto de partida, y un referente para la creación de otras bases de datos basadas en información molecular.

Fuente Madridasd

Los orígenes de la Bioinformática (III). Sabemos que llevan información, pero ¿cuál?

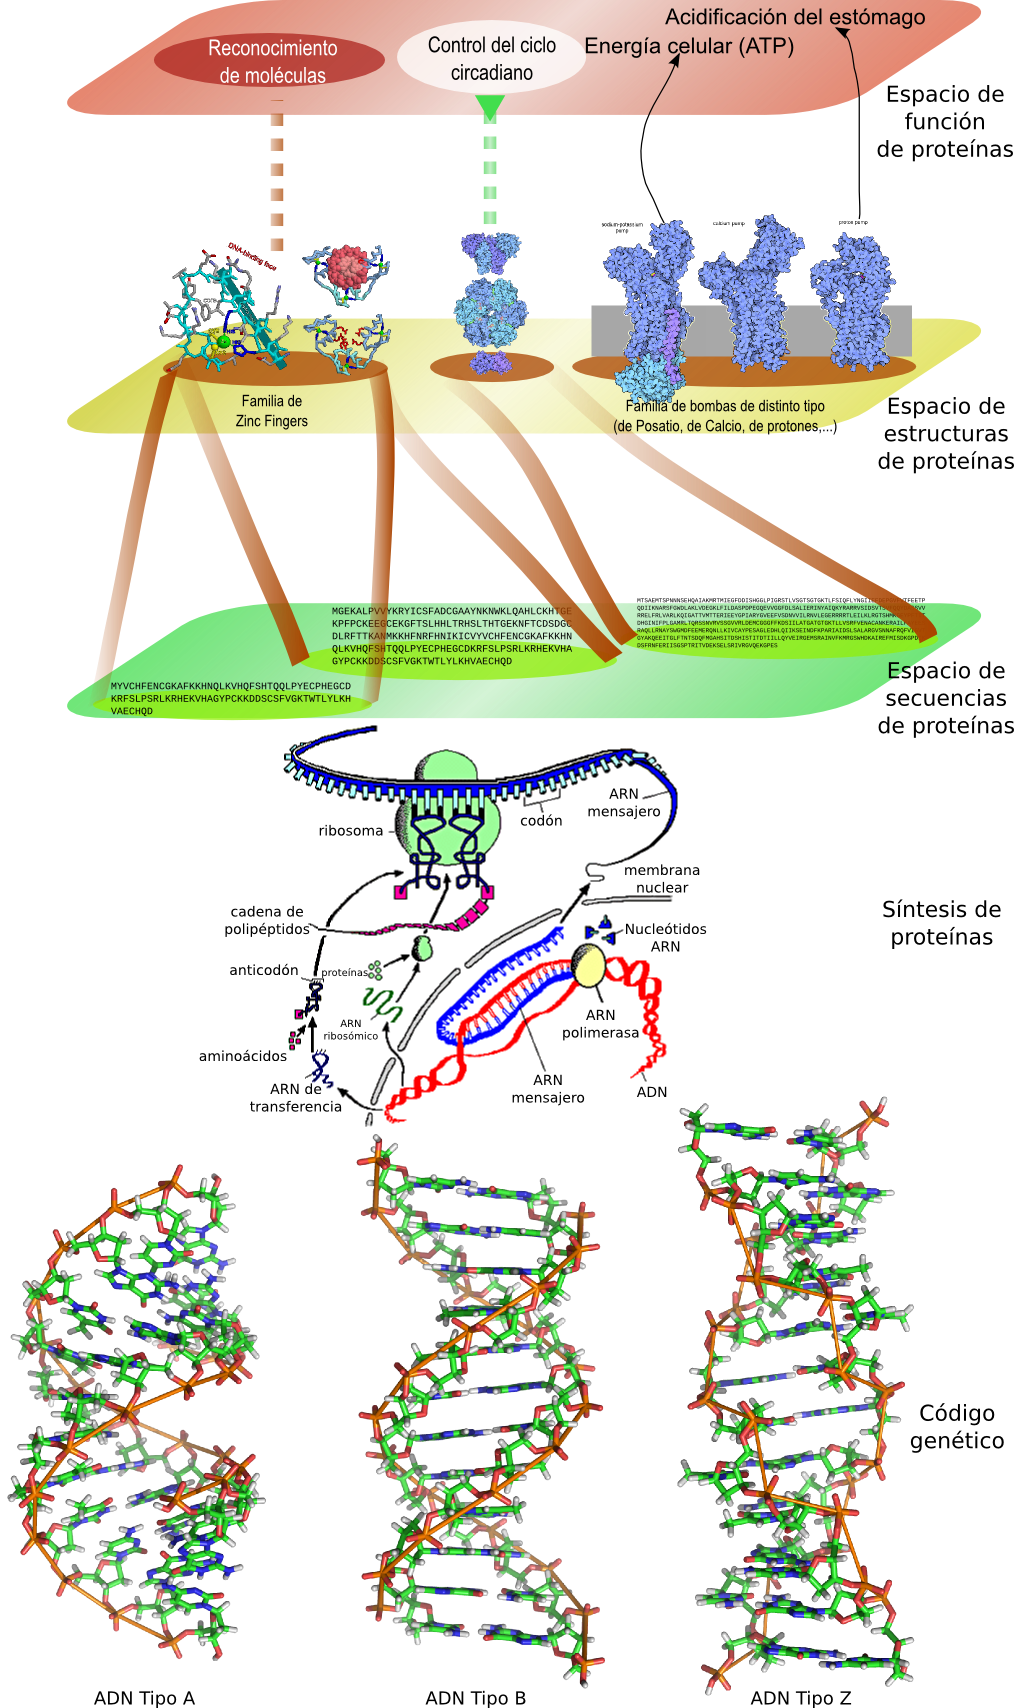
Una vez que quedó demostrado que las proteínas eran secuencias de aminoácidos donde importaba el orden de los mismos, y que se empezó a secuenciar cada vez más proteínas, el repositorio de información asociado a las proteínas secuenciadas empezó a crecer poco a poco, pero todavía no se habían establecido las correspondencias entre el código genético (el ADN, compuesto de nucleótidos) y las proteínas (compuestas de aminoácidos), ni entre la secuencia de una proteína y su estructura y funcionalidad.

Correspondencias entre ADN, espacio de proteínas, espacio de estructuras de proteínas y función de proteínasA finales de 1950 los experimentos realizados por Christian Anfinsen y sus colaboradores mostraron que, una vez desnaturalizada la ribonucleasa (vamos, que perdió su conformación tridimensional y se quedó hecha un hilo), volvía a recuperar de forma espontánea su conformación tridimensional. Con ello quedó asentado el concepto de que la estructura tridimensional de una proteína está determinada única y exclusivamente por su secuencia de aminoácidos.

El problema bioinformático que hasta día de hoy no está resuelto de forma general es el de cómo calcular esa estructura tridimensional de la proteína a partir de la secuencia de aminoácidos. Dado que a nivel experimental es muchísimo más fácil secuenciar una proteína que obtener su estructura tridimensional mediante cristalografía de rayos X o resonancia magnética nuclear, la resolución del problema a nivel bioinformático simplificaría mucho la tarea en otras áreas. La estructura de una proteína determina su funcionalidad y participación en el metabolismo de los organismos, y proteínas con estructuras similares juegan papeles similares. Aunque dos proteínas con secuencias muy parecidas tienen siempre estructuras muy parecidas (y por tanto, funcionalidades muy parecidas), dos proteínas con secuencias distintas también pueden tener estructuras similares (por convergencia evolutiva) y por ello funcionalidades parecidas.

Y en la próxima entrega, la aparición de la biología computacional.

Fuente Madridasd

Los orígenes de la Bioinformática (II) Las macromoléculas llevan información

El concepto de que las proteínas (que a fin de cuentas son macromoléculas) contienen información que está codificada en forma de secuencias lineales de aminoácidos lleva mucho tiempo totalmente aceptado por la comunidad científica, y es la piedra angular de toda la bioinformática clásica. Pero esto no fue siempre así, teniendo que remontarnos a los años posteriores a la Segunda Guerra Mundial para encontrar las primeras pruebas empíricas de esta idea. El bioquímico Emil Smith (que no lo debéis confundir con Temple Smith, del algoritmo Smith & Waterman) describió este periodo como “heroico” para la bioquímica de proteínas. El periodo heroico comprendería desde 1945 a 1955, cuando fue publicada la secuencia completa de la insulina gracias al esfuerzo de Frederick Sanger (sí, el que da nombre al Sanger Centre) y sus colaboradores.

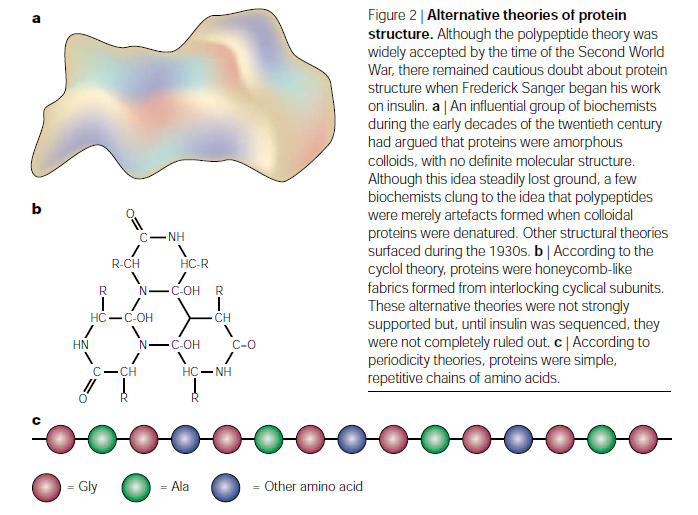
Hipótesis alternativa de la estructura de proteínas
Hipótesis alternativa de la estructura de proteínas, del periodo heroico

Resumiendo mucho la historia, Frederick Sanger tomó como base el postulado (ahora teoría) sobre polipéptidos en la estructura de las proteínas. Este postulado, formulado inicialmente en 1902, generó mucho escepticismo en la comunidad científica, siendo más aceptadas las hipótesis alternativas (que en su época parecían más creibles). Algunas de ellas están reflejadas en la figura que he puesto. Una de ellas postulaba que las proteínas eran una especie de coloides amorfos, sin estructura definida, y que los polipéptidos se generaban al desnaturalizarse esos coloides. Otra promovía la idea de que las proteínas tenían forma de mallas con estructuras de celdas de colmena, tan típicas del anillo de benceno y los compuestos aromáticos. Y la última de la figura refleja una idea similar, pero no igual, en la que se consideraba la linealidad de la proteína incluso a nivel estructural, donde se consideraba que era una macromolécula periódica compuesta por repeticiones de de cadenas de aminoácidos.

Las técnicas experimentales habían mejorado ostensiblemente en las décadas de 1930 y 1940, pero antes del trabajo del equipo de Frederick Sanger no se sabía apenas nada sobre la posición específica o el orden de cada aminoácido en la proteína, o de su estructura. La resolución y publicación de la secuencia de aminoácidos de la insulina permitió descartar todas las hipótesis erróneas y comprobar a la idea básica de que las proteínas están compuestas de aminoácidos, que esos aminoácidos tienen un orden lineal (secuencia o estructura 1D), y que esos aminoácidos en ese orden específico determinan la estructura de la proteína (estructuras 2D y 3D). El trabajo experimental que condujo a la obtención de la secuencia de la insulina (de sólo 51 aminoácidos) fue bastante arduo, porque requería de químicos muy experimentados en la degradación de las proteínas fueran capaces de determinar de forma muy precisa en qué estado de degradación se encontraban las muestras, e ir controlando esa degradación.

Pero al mismo tiempo otros bioquímicos estaban desarrollando métodos más refinados, como la reacción de degradación de Edman, que permitió ir quitando de una cadena peptídica pequeña uno a uno sus aminoácidos, de forma secuencial. Esta nueva técnica permitió semiautomatizar todo el proceso, lo cuál fue una revolución para el mundo de la biología molecular. Por ejemplo, con esta nueva técnica la secuenciación de la ribonucleasa (realizada por el equipo coordinado por Stanford Moore y William Stein del Instituo Rockefeller), una proteína de 124 aminoácidos, llevó la mitad de tiempo que la obtención de la secuencia de la insulina.

A finales de la década de 1960 Pehr Edman consiguió automatizar por completo todo el proceso con su “sequenator”, lo cuál hizo que muchos grupos de biología molecular hicieran crecer la cada vez mayor biblioteca de secuencias de proteínas. Sin estos primeros esfuerzos y entonces nuevas técnicas experimentales habría sido muy difícil que nacieran las bases de datos de secuencias, o que se hubiera si quiera soñado en proyectos de secuenciación del genoma completo de un organismo. Y sin ello la bioinformática, la biología molecular y muchas otras disciplinas relacionadas con las ciencias de la vida posiblemente serían muy diferentes.

Fuente Madridasd